







Cerebrium
KI-gestützt
Serverless-GPU-Plattform für Voice Agents, Videomodelle und LLMs mit Abrechnung pro Sekunde
Cerebrium.aiÖffnet in neuem TabIst das Ihr Tool? Diese Seite beanspruchen
Beanspruchen Sie Ihre Tool-Seite
Kostenlos zu beanspruchen • Premium-Funktionen verfügbar
- Verifiziertes Abzeichen – Zeigen Sie den Nutzern, dass Ihr Tool legitim ist, mit einem verifizierten Häkchen, das sofortige Glaubwürdigkeit aufbaut.
- Ihr Profil bearbeiten – Aktualisieren Sie Beschreibungen, Screenshots, Preise und halten Sie Ihre Auflistung genau und aktuell.
- Sichtbarkeit erhöhen – Erhalten Sie hervorgehobene Platzierungen, eine priorisierte Auflistung in Kategorien und Werbebadges, um sich abzuheben.
- Auf Bewertungen reagieren – Engagieren Sie sich mit Ihren Nutzern, indem Sie auf Feedback reagieren und Vertrauen bei potenziellen Kunden aufbauen.
Folgen für Updates & Angebote
Erhalten Sie Benachrichtigungen für Cerebrium Rabatte, neue Features & Preisänderungen
Ähnliche Tools

Text Generator
OpenAI-kompatible API, die über einen Endpunkt Zugriff auf viele KI-Modelle für Text, Bild und Sprache bietet
Runware
Eine API für Bild-, Video-, Audio-, Sprach- und 3D-KI-Modelle, dazu Serverless- und reservierte GPUs
Respan
Open-Source-KI-Gateway mit integrierter Observability, Prompt-Verwaltung und Evaluierungen
Luxand.cloud
Cloud-API für Gesichtserkennung, um Gesichter in Web- und Mobil-Apps zu erkennen, abzugleichen und zu durchsuchen
Promptmetheus
Prompt-Engineering-IDE zum Erstellen, Testen und Optimieren von Prompts für über 150 LLMs
Novita AI
KI-Cloud mit Modell-APIs, Agenten-Sandboxes und GPU-Instanzen für Entwickler
Cekura
Plattform für automatisiertes Testen und Monitoring von Sprach- und Chat-KI-Agenten
Pig
API und Chat-Oberfläche zum Starten und Automatisieren von Windows-Apps mit KI, die den Computer bedient
Neue Tools

RambleFix
Verwandelt gesprochene Sprachnotizen auf Web, iPhone und Mac in fertige E-Mails, Notizen und Zusammenfassungen

QuickCreator
KI-Content-Team aus Agenten, das SEO-Artikel recherchiert, schreibt und in Ihrer Markenstimme optimiert

Linfo.ai
Fasst Artikel, YouTube-Videos und Dokumente zu Kernaussagen, Gliederungen und Mindmaps zusammen

Brain Pod AI
KI-Plattform für Texte, Bilder und Chat, die sich nun zu Charigent mit KI-Charakteren und Workflows weiterentwickelt

AutoBlogging.Pro
Erstellt SEO-optimierte Blogartikel mit GPT-Modellen und veröffentlicht sie automatisch auf WordPress

Vsub
Verwandelt Skripte oder Voiceover mit Ihrer eigenen Stilvorlage in illustrierte Faceless-Videos mit Erzählung

VideoToPage
Verwandelt YouTube-Videos, Uploads und Aufnahmen in Blogbeiträge, Artikel und Social-Media-Beiträge

Cerebrium Medien-Galerie
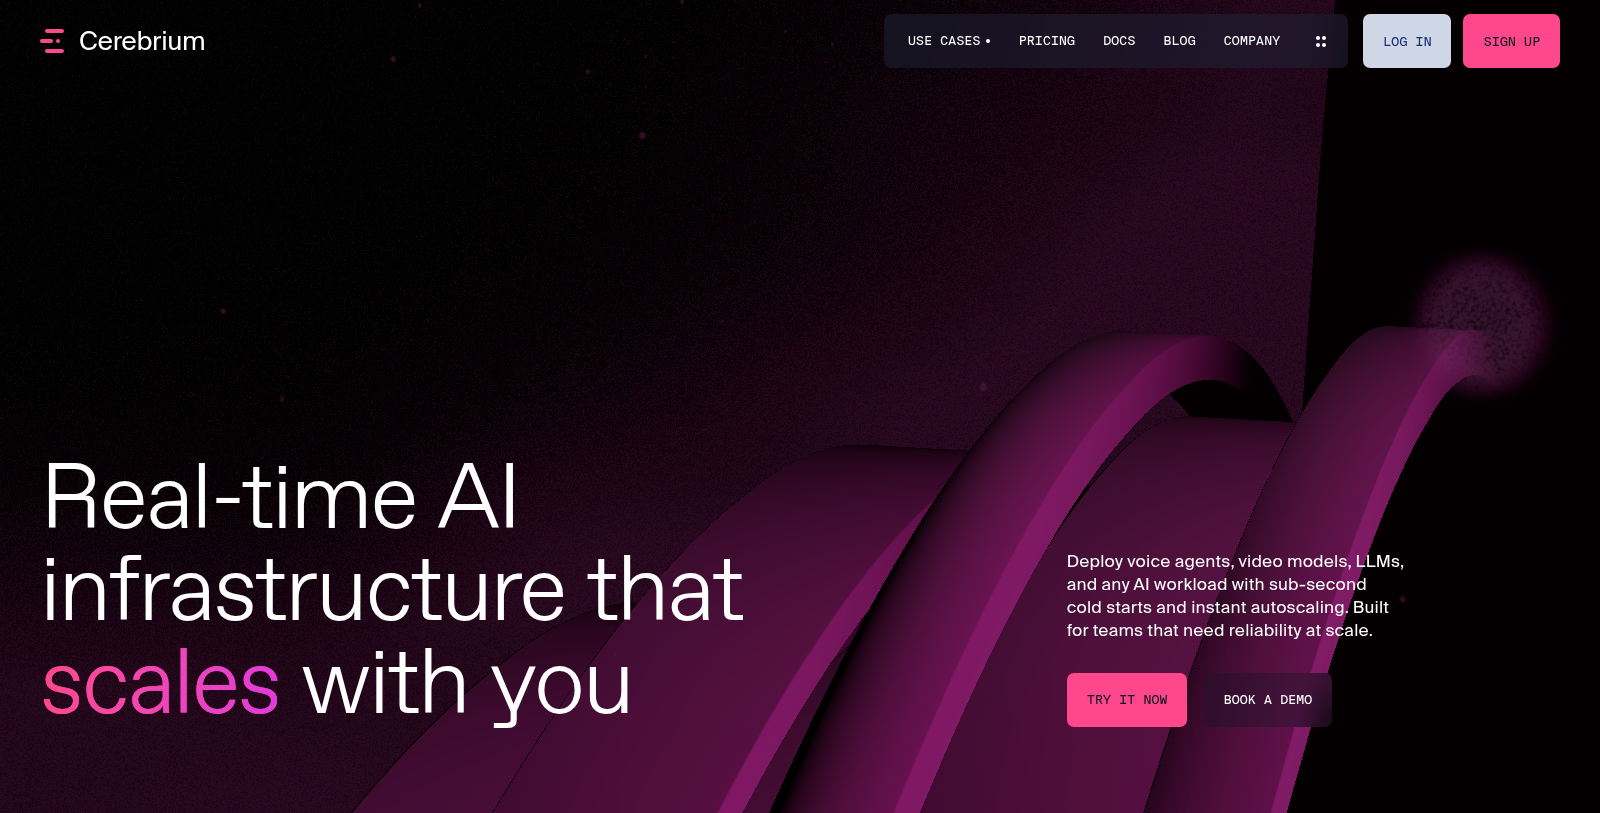
Screenshot von Cerebrium
Was ist Cerebrium?
Cerebrium ist eine Serverless-Plattform zum Bereitstellen und Skalieren von KI-Workloads wie Voice Agents, Videomodellen und großen Sprachmodellen auf GPUs. Die Website hebt schnelle Cold Starts hervor und erklärt, dass Sie Kubernetes nicht selbst verwalten müssen.
Abgerechnet wird pro Sekunde tatsächlicher Rechenzeit, mit ausgewiesenen Preisen für mehrere GPU-Typen, CPU, Arbeitsspeicher und Speicher. Der Hobby-Tarif ist abgesehen von den Rechenkosten kostenlos, der Standard-Tarif kostet eine monatliche Gebühr mit unbegrenzter Anzahl an Nutzern und Apps, und Enterprise ist individuell.
Das Angebot richtet sich an Entwickler und KI-Teams, die Inferenz im Produktivbetrieb ohne eigene GPU-Infrastruktur ausführen möchten. Das Unternehmen veröffentlicht Code auf GitHub und pflegt einen Blog. Die Nutzung wird gemessen, sodass die Kosten von der Rechenzeit abhängen, die jede App tatsächlich verbraucht.
Vorteile & Nachteile
Vorteile
- Serverlose GPU-Plattform, die KI-Workloads je nach Nachfrage skaliert
- Die Website hebt schnelle Kaltstarts für GPU-basierte KI-Workloads hervor
- Nutzer müssen laut der offiziellen Website kein Kubernetes verwalten
Nachteile
Häufig gestellte Fragen
Was kostet Cerebrium?
Cerebrium ist kostenlos verfügbar.
Hat Cerebrium ein lebenslanges Angebot?
Laut unseren neuesten Informationen scheint dieses Tool derzeit leider kein lebenslanges Angebot zu haben.
Welche Arten von Workloads kann ich auf Cerebrium ausführen?
Cerebrium wurde für KI-Workloads entwickelt, die GPUs benötigen, etwa Sprach-Agenten, Videomodelle und große Sprachmodelle. Die Website beschreibt es als serverlose Möglichkeit, diese Workloads in der Produktion bereitzustellen und zu skalieren. Hauptzielgruppe sind Teams, die Inferenz ausführen möchten, ohne eigene GPU-Infrastruktur zu betreiben.
Muss ich Kubernetes verwalten, um Cerebrium zu nutzen?
Laut der offiziellen Website müssen Sie Kubernetes nicht verwalten, um Ihre Workloads auf Cerebrium auszuführen. Die Plattform übernimmt die Skalierung bei wechselnder Nachfrage, und schnelle Kaltstarts gehören zu den Hauptmerkmalen. Lesen Sie vor Projektbeginn die aktuelle Bereitstellungsdokumentation, da sich Einrichtungsdetails ändern können.
Wie skaliert Cerebrium meine Apps?
Cerebrium skaliert Apps je nach Nachfrage, und die Website hebt schnelle Kaltstarts als Teil des serverlosen Designs hervor. Ziel ist es, Workloads ohne eigene Verwaltung der darunterliegenden Infrastruktur auszuführen. Für genaue Skalierungsgrenzen und Konfigurationsoptionen ist die offizielle Dokumentation die richtige Quelle.
Für wen eignet sich Cerebrium am besten?
Cerebrium richtet sich an Entwickler und KI-Teams, die Inferenz in der Produktion betreiben müssen. Das Unternehmen veröffentlicht Code auf GitHub und pflegt einen Blog, was beim Einstieg in die Plattform helfen kann. Hobbyisten können mit dem Hobby-Tarif beginnen, wobei für die ausgeführten Rechenleistungen dennoch Kosten anfallen.
Kann ich Sprach-Agenten oder Videomodelle darauf bereitstellen?
Ja, laut der Website ist Cerebrium dafür ausgelegt, Sprach-Agenten, Videomodelle und große Sprachmodelle auf GPUs bereitzustellen und zu skalieren. Schnelle Kaltstarts werden für diese Workloads hervorgehoben. Prüfen Sie Ihr konkretes Modell oder Framework anhand der offiziellen Dokumentation, bevor Sie sich für ein Projekt festlegen.
Hinweis: Diese Website verwendet Affiliate-Links, um Provisionen von Verkäufen zu verdienen. Bitte lesen Sie die Nutzungsbedingungen, bevor Sie sich irgendwo anmelden.