







LibreCrawl
Crawler SEO open source z nielimitowanymi audytami URL i renderowaniem JavaScript, bez opłat licencyjnych.
Librecrawl.comOtwiera się w nowej karcieTo Twoje narzędzie? Przejmij tę stronę
Przejmij stronę swojego narzędzia
Przejęcie za darmo • Dostępne funkcje premium
- Znaczek weryfikacji – Pokaż użytkownikom, że Twoje narzędzie jest wiarygodne, dzięki znaczkowi weryfikacji, który od razu buduje zaufanie.
- Edytuj swój profil – Aktualizuj opisy, zrzuty ekranu i cennik, aby wpis był dokładny i aktualny.
- Większa widoczność – Zyskaj wyróżnione miejsca, priorytet w kategoriach i plakietki promocyjne, by się wyróżnić.
- Odpowiadaj na opinie – Odpowiadaj na opinie użytkowników i buduj zaufanie potencjalnych klientów.
Obserwuj, by być na bieżąco z nowościami i promocjami
Otrzymuj powiadomienia o zniżkach, nowych funkcjach i zmianach cen narzędzia LibreCrawl
Podobne narzędzia
Yext
Zarządzaj informacjami o firmie w kanałach cyfrowych dla marek z wieloma lokalizacjami.
Screaming Frog SEO Spider
Skanuje strony internetowe, wykrywa techniczne problemy SEO i analizuje wydajność stron.
AlsoAsked
Narzędzie do researchu słów kluczowych, które pokazuje zapytania użytkowników z sekcji „People Also Ask” Google
SE Ranking
Kompleksowe oprogramowanie SEO do śledzenia słów kluczowych, analizy linków zwrotnych i raportowania.
VidStats
Panel analityczny YouTube z wyświetleniami na żywo oraz narzędzia AI do tytułów, SEO, miniatur i publikacji
VOC.AI
Platforma analizy opinii, która zamienia recenzje kupujących z marketplace'ów we wnioski o produktach i rynku
User Evaluation
Wywiadowca AI prowadzi rozmowy z klientami i odsyła każde twierdzenie do nagrania
Profound
Platforma marketingowa AI, która śledzi widoczność marki w wyszukiwaniu AI i uruchamia agentów do działania
Nowe narzędzia

Text Generator
API zgodne z OpenAI, dające dostęp do wielu modeli tekstu, obrazu i mowy AI przez jeden punkt końcowy

RambleFix
Zamienia mówione notatki głosowe w dopracowane e-maile, notatki i streszczenia w przeglądarce, na iPhonie i Macu

QuickCreator
Zespół agentów AI do treści, który bada temat, pisze i optymalizuje artykuły SEO w głosie Twojej marki

Linfo.ai
Streszcza artykuły, filmy z YouTube i dokumenty w kluczowe wnioski, konspekty i mapy myśli

Brain Pod AI
Platforma AI do pisania, obrazów i czatu, przekształcana obecnie w Charigent z postaciami AI i przepływami pracy

AutoBlogging.Pro
Generuje artykuły blogowe zoptymalizowane pod SEO za pomocą modeli GPT i automatycznie publikuje je w WordPressie

Vsub
Zamienia scenariusz lub lektora w ilustrowane filmy bez twarzy z narracją, w stylu Twojego szablonu

VideoToPage
Zamienia filmy z YouTube, przesłane pliki i nagrania we wpisy na bloga, artykuły i posty społecznościowe

Galeria multimediów LibreCrawl
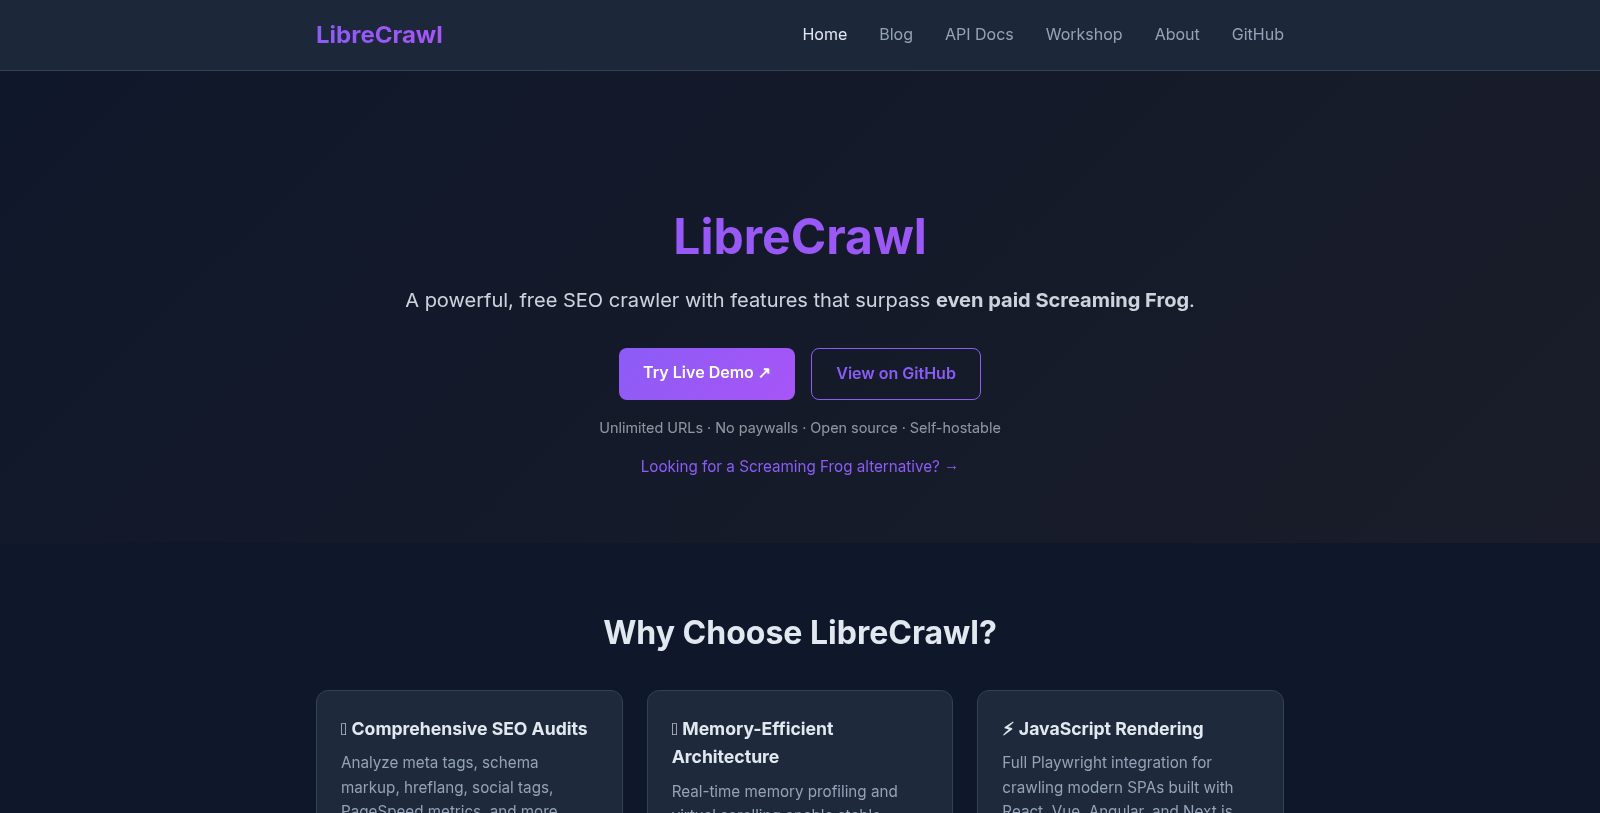
Zrzut ekranu narzędzia LibreCrawl
Czym jest LibreCrawl?
LibreCrawl to wydajny, darmowy crawler SEO o funkcjach przewyższających nawet płatne narzędzia, takie jak Screaming Frog. Powstał z misją upowszechnienia technicznego SEO i usuwa sztuczne ograniczenia, takie jak limit 500 adresów URL, oraz wysokie opłaty licencyjne. Umożliwia crawlowanie nieograniczonej liczby adresów URL, renderowanie JavaScript i kompleksowe audyty techniczne, oferując niezrównane możliwości bez obciążenia finansowego.
Dlaczego warto wybrać LibreCrawl?
Dzięki nacisku na dostępność i wydajność LibreCrawl przeprowadza kompleksowe audyty SEO, które analizują różne metatagi, znaczniki schema, atrybuty hreflang, tagi społecznościowe, wskaźniki PageSpeed i nie tylko. Oszczędna pod względem pamięci architektura zapewnia płynną obsługę crawlowania, nawet w serwisach przekraczających milion adresów URL, dzięki profilowaniu pamięci w czasie rzeczywistym i technologii wirtualnego przewijania.
Najważniejsze funkcje:
- Nielimitowane crawlowanie: analizuj dowolną liczbę adresów URL bez ograniczeń.
- Renderowanie JavaScript: pełna integracja z Playwright pozwala dokładnie crawlować nowoczesne aplikacje SPA zbudowane na frameworkach takich jak React, Vue, Angular i next.js.
- Nielimitowany eksport: eksportuj dane w formatach CSV, JSON lub XML. Twórz dowolnie wiele eksportów bez ograniczeń i wybieraj własne pola.
- Open source i możliwość samodzielnego hostowania: w pełni przejrzysty kod dostępny na licencji MIT na GitHubie daje pełną kontrolę nad danymi i zapewnia prywatność.
- Zaawansowane funkcje: liczne nowoczesne funkcje, takie jak filtrowanie problemów, wstrzykiwanie własnego CSS, obsługa wielu sesji i szczegółowe śledzenie linków, pozwalają dopasować crawlowanie do własnych potrzeb.
Korzyści dla różnych typów użytkowników:
Agencje SEO dzięki LibreCrawl nie muszą martwić się o koszty licencji i mogą sprawnie wykonywać nielimitowane audyty dla klientów. Agencje mogą rozrosnąć się z dwóch do dwudziestu osób bez zwiększania budżetu na oprogramowanie.
Zespoły korporacyjne doceniają obsługę dużych, złożonych serwisów bez znaczących kosztów i ograniczeń. Możliwość samodzielnego hostowania zapewnia zgodność z rygorystycznymi standardami bezpieczeństwa i prywatności danych, odpowiadając potrzebom firm.
Freelancerzy zyskują zerowe koszty roczne i dostęp do profesjonalnych narzędzi analitycznych, które pozwalają skutecznie konkurować w branży. Sklepy internetowe mogą sprawnie audytować ogromne katalogi produktów i dbać o poprawność SEO na tysiącach stron.
Wydawcy treści i serwisy medialne mogą poprawiać swoje wyniki, audytując strategie linkowania wewnętrznego, weryfikując znaczniki schema i zwiększając możliwość odnalezienia treści. Firmy SaaS i technologiczne mogą ponadto dzięki rzetelnym ocenom LibreCrawl zadbać o optymalizację swoich serwisów marketingowych i dokumentacji pod kątem wyszukiwarek.
Funkcje techniczne: bliższe spojrzenie
LibreCrawl doskonale radzi sobie z technicznym SEO. Wykrywa takie problemy jak uszkodzone linki, zduplikowane treści, przekierowania i brakujące metadane, a przy tym weryfikuje wdrożenie danych strukturalnych. Zaawansowane funkcje pozwalają dokładnie analizować strukturę linkowania wewnętrznego i wskaźniki szybkości stron, co zapewnia solidną optymalizację stale zmieniających się serwisów.
Zaangażowanie społeczności:
LibreCrawl rozwija się dzięki zaangażowaniu społeczności. Jego rozwój opiera się na opiniach i wkładzie użytkowników, tworząc współpracujący ekosystem. Użytkownicy mogą wpływać na przyszłe funkcje i ulepszenia, co umacnia filozofię open source.
Jak zacząć:
Instalacja LibreCrawl jest prosta i wymaga podstawowej znajomości wiersza poleceń. Funkcje można też przetestować bez instalacji w wersji demo. Osoby zainteresowane dostosowaniem narzędzia mogą skorzystać z licencji MIT, która pozwala na szerokie modyfikacje pod różne potrzeby.
Podsumowując, LibreCrawl jest mocną alternatywą dla typowych crawlerów i ułatwia dostęp do zaawansowanych możliwości SEO. Dzięki szerokiemu zestawowi funkcji i bezpłatności skutecznie spełnia współczesne wymagania branży bez kompromisów.
Zalety i wady
Zalety
- Crawlowanie nieograniczonej liczby adresów URL bez sztucznych limitów i opłat.
- Zaawansowane funkcje, takie jak renderowanie JavaScript i profilowanie pamięci na żywo.
- W pełni open source z pełną kontrolą nad wdrożeniem i prywatnością danych.
Wady
- Brak dedykowanego wsparcia komercyjnego i specjalistycznych funkcji, np. analizy logów serwera.
Najczęściej zadawane pytania
Ile kosztuje LibreCrawl?
LibreCrawl jest dostępne bezpłatnie.
Czy LibreCrawl ma ofertę dożywotnią?
Według naszych najnowszych informacji to narzędzie niestety nie ma obecnie oferty dożywotniej.
Jakie zaawansowane funkcje wyróżniają LibreCrawl na tle innych crawlerów SEO?
LibreCrawl oferuje kilka zaawansowanych funkcji, w tym profilowanie pamięci w czasie rzeczywistym, wirtualne przewijanie zapewniające stabilne crawlowanie ponad miliona adresów URL oraz wbudowane renderowanie JavaScript z użyciem Playwright. Ma też filtrowanie problemów, obsługę wielu sesji dla równoległych projektów, wstrzykiwanie własnego CSS i nielimitowany eksport w formatach CSV, JSON lub XML. Funkcje te mają zapewniać kompleksowy audyt techniczny SEO bez ograniczeń typowych dla innych narzędzi.
Jak LibreCrawl dba o prywatność użytkowników?
LibreCrawl zaprojektowano z silnym naciskiem na prywatność. Nie śledzi użytkowników ani nie zbiera danych analitycznych o zachowaniu podczas crawlowania. Ponieważ jest to narzędzie open source, użytkownicy mają pełny dostęp do kodu i mogą sprawdzić, że żadne dane nie trafiają na serwery stron trzecich. Dla maksymalnej kontroli zaleca się hostowanie LibreCrawl na własnej infrastrukturze, tak aby wszystkie dane z crawlowania pozostawały prywatne i pod Twoją kontrolą.
Czy mogę uruchomić LibreCrawl na własnym serwerze i jakie są wymagania instalacyjne?
Tak, LibreCrawl można hostować samodzielnie i uruchamiać na własnych serwerach. Instalacja jest prosta dla osób z podstawowymi umiejętnościami administrowania serwerem. Wymagany jest Python 3.8 lub nowszy, a konfiguracja obejmuje sklonowanie repozytorium, instalację potrzebnych zależności i uruchomienie instalatora Playwright, który pobiera pliki binarne przeglądarek. Szczegółowe instrukcje znajdziesz w repozytorium na GitHubie.
Jak działa nielimitowane crawlowanie adresów URL w LibreCrawl?
LibreCrawl pozwala crawlować nieograniczoną liczbę adresów URL bez ograniczeń i barier płatności. W odróżnieniu od innych narzędzi, które limitują crawlowanie w zależności od planu subskrypcji, jedynym ograniczeniem LibreCrawl jest wydajność sprzętu użytkownika. Narzędzie wykorzystuje zaawansowane techniki zarządzania pamięcią, dzięki czemu sprawnie obsługuje duże serwisy, nawet te z milionami stron.
Jakie integracje i formaty eksportu obsługuje LibreCrawl?
LibreCrawl obsługuje kilka formatów eksportu, w tym CSV, JSON i XML, do raportowania lub integracji z innymi narzędziami. Oferuje też eksport z możliwością dostosowania, w którym można wybrać pola uwzględniane w raportach. Nielimitowany eksport pozwala tworzyć dowolnie wiele raportów bez ograniczeń co do rozmiaru czy częstotliwości.
Czy istnieje społeczność wsparcia i jak uzyskać pomoc w razie problemów z LibreCrawl?
Tak, LibreCrawl ma aktywną społeczność, która udziela wsparcia na GitHubie. Można zgłaszać błędy, proponować funkcje i omawiać problemy w sekcjach GitHub Issues i Discussions. Wiele typowych pytań wyjaśnia także dokumentacja. Społeczność słynie z szybkich odpowiedzi, często w ciągu 24–48 godzin, co pomaga sprawnie rozwiązywać problemy.
Jaki sprzęt zaleca się do dużych crawli w LibreCrawl?
Dla małych i średnich serwisów (poniżej 100 000 adresów URL) wystarczy komputer z 8 GB RAM i nowoczesnym procesorem. Przy większych crawlach, zwłaszcza obejmujących miliony adresów URL, zaleca się 16–32 GB RAM. LibreCrawl ma funkcję profilowania pamięci, która pomaga monitorować zużycie zasobów i optymalizować ustawienia pod kątem konkretnego sprzętu.
Czy mogę dostosować LibreCrawl do własnych potrzeb technicznego SEO?
Oczywiście! LibreCrawl jest open source i działa na licencji MIT, więc można rozwidlić repozytorium, zmodyfikować kod źródłowy i dodać własne funkcje lub dostosowania. Można zmieniać reguły wykrywania problemów, wdrażać nowe formaty eksportu, a nawet stworzyć własny interfejs. Modyfikacje można zachować dla siebie, ale mile widziane jest przekazywanie zmian do głównego projektu, z korzyścią dla społeczności.
Porównania: LibreCrawl
Uwaga: ta strona używa linków afiliacyjnych, dzięki którym zarabia prowizję od sprzedaży. Przed rejestracją zapoznaj się z regulaminem danej usługi.