







Thinkless
Oparte na AI
Framework dla LLM, który optymalizuje rozumowanie, dobierając złożoność odpowiedzi do wymagań zadania.
Github.comOtwiera się w nowej karcieTo Twoje narzędzie? Przejmij tę stronę
Przejmij stronę swojego narzędzia
Przejęcie za darmo • Dostępne funkcje premium
- Znaczek weryfikacji – Pokaż użytkownikom, że Twoje narzędzie jest wiarygodne, dzięki znaczkowi weryfikacji, który od razu buduje zaufanie.
- Edytuj swój profil – Aktualizuj opisy, zrzuty ekranu i cennik, aby wpis był dokładny i aktualny.
- Większa widoczność – Zyskaj wyróżnione miejsca, priorytet w kategoriach i plakietki promocyjne, by się wyróżnić.
- Odpowiadaj na opinie – Odpowiadaj na opinie użytkowników i buduj zaufanie potencjalnych klientów.
Obserwuj, by być na bieżąco z nowościami i promocjami
Otrzymuj powiadomienia o zniżkach, nowych funkcjach i zmianach cen narzędzia Thinkless
Podobne narzędzia

Text Generator
API zgodne z OpenAI, dające dostęp do wielu modeli tekstu, obrazu i mowy AI przez jeden punkt końcowy

Brain Pod AI
Platforma AI do pisania, obrazów i czatu, przekształcana obecnie w Charigent z postaciami AI i przepływami pracy
SellMeThisPen
Platforma AI do coachingu sprzedaży z ćwiczeniem scenek, osobistym trenerem głosowym 1:1 i asystentem rozmów na żywo
Toby
Symulator rozmów kwalifikacyjnych AI z ćwiczeniem w stylu wideorozmowy i oceną po sesji
Myreader
Asystent czytania AI: zadawaj pytania do wgranych książek, artykułów i dokumentów, z odwołaniami do stron
ZeroTwo
Agent AI, który planuje cel, pracuje na Twoich plikach, aplikacjach i w sieci, a na koniec oddaje gotową pracę
Toki
Asystent AI dla zapracowanych, który zajmuje się e-mailami, kalendarzem, rezerwacjami i ważnymi sprawami
Tabbit
Przeglądarka desktopowa oparta na AI z czatem ze stroną, agentem do zadań, własnymi umiejętnościami i porządkowaniem kart
Nowe narzędzia

RambleFix
Zamienia mówione notatki głosowe w dopracowane e-maile, notatki i streszczenia w przeglądarce, na iPhonie i Macu

QuickCreator
Zespół agentów AI do treści, który bada temat, pisze i optymalizuje artykuły SEO w głosie Twojej marki

Linfo.ai
Streszcza artykuły, filmy z YouTube i dokumenty w kluczowe wnioski, konspekty i mapy myśli

AutoBlogging.Pro
Generuje artykuły blogowe zoptymalizowane pod SEO za pomocą modeli GPT i automatycznie publikuje je w WordPressie

Vsub
Zamienia scenariusz lub lektora w ilustrowane filmy bez twarzy z narracją, w stylu Twojego szablonu

VideoToPage
Zamienia filmy z YouTube, przesłane pliki i nagrania we wpisy na bloga, artykuły i posty społecznościowe

Galeria multimediów Thinkless
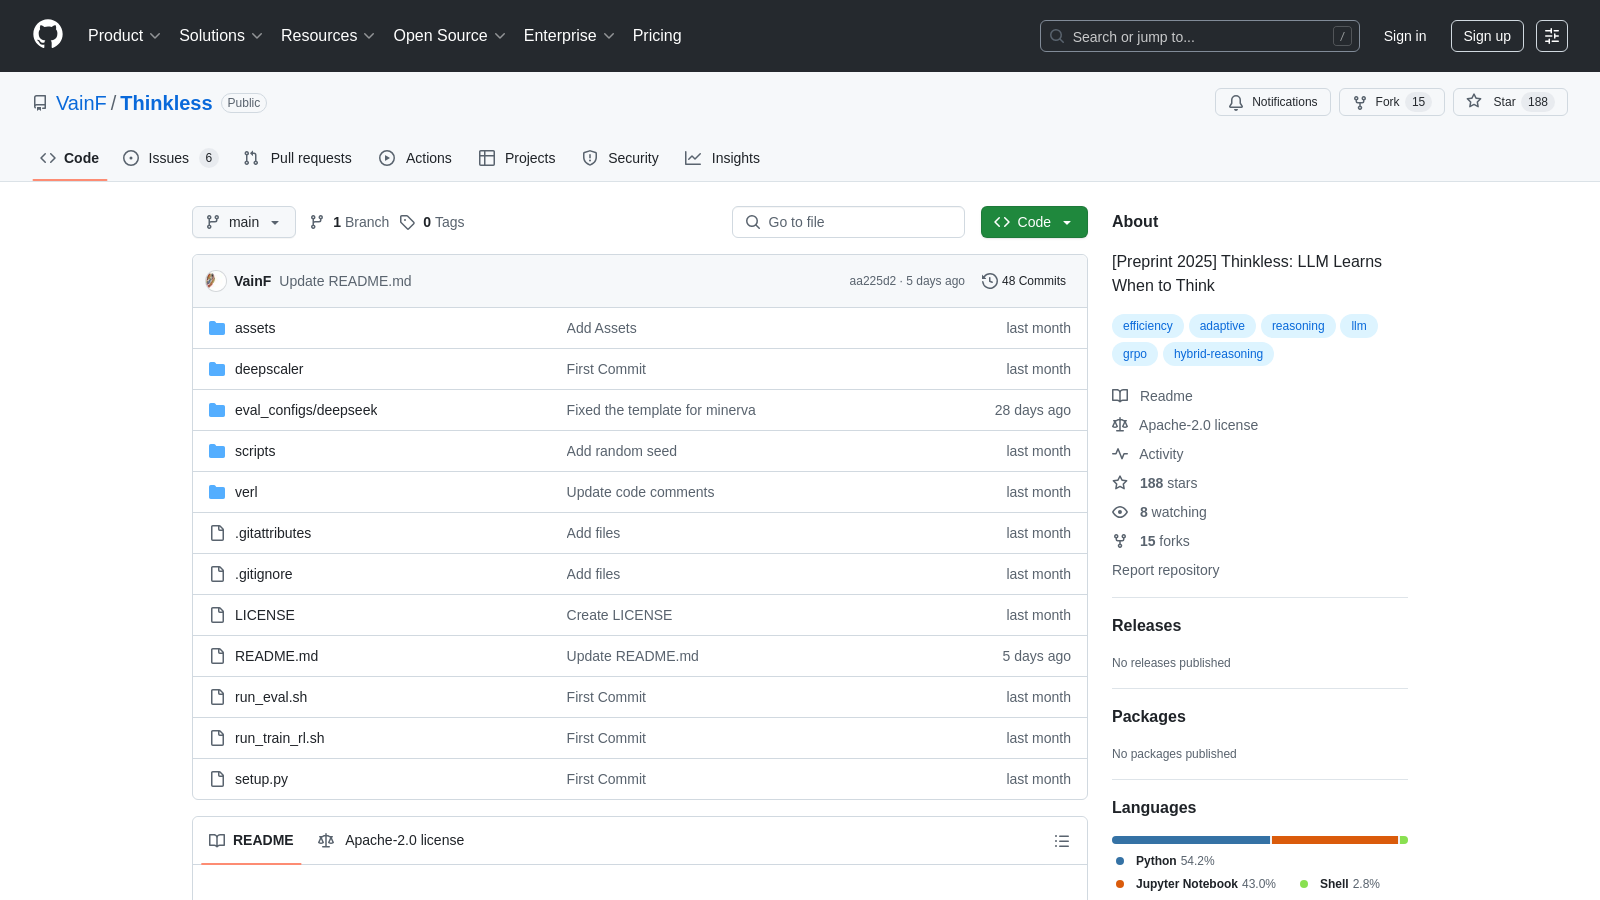
Zrzut ekranu narzędzia Thinkless
Czym jest Thinkless?
Thinkless to innowacyjny framework dla dużych modeli językowych (LLM), który uczy je, kiedy warto krytycznie przemyśleć sprawę przed udzieleniem odpowiedzi. Dzięki unikalnemu paradygmatowi trenowania opartemu na uczeniu ze wzmocnieniem Thinkless optymalizuje rozumowanie w dużych modelach językowych (LLM) i pozwala im wybierać między krótką a długą odpowiedzią w zależności od złożoności zadań. Niedawno framework został znacząco ulepszony, co umocniło jego pozycję wiodącego rozwiązania dla adaptacyjnego rozumowania w LLM.
Główną innowacją Thinkless jest zaawansowane wykorzystanie algorytmu Decoupled Group Relative Policy Optimization (DeGRPO). To podejście rozdziela cele uczenia na dwa osobne składniki: jeden odpowiada za wybór trybu rozumowania za pomocą straty tokenu sterującego, a drugi zwiększa dokładność generowanych odpowiedzi dzięki stracie odpowiedzi. Takie rozdzielenie nie tylko stabilizuje proces trenowania, ale też zmniejsza obciążenie obliczeniowe związane z rozumowaniem LLM, co pozwala działać wydajniej. Wprowadzono też ulepszenia algorytmu, które poprawiają stabilizację trenowania i zapobiegają załamaniu wydajności, często spotykanemu w naiwnych implementacjach podobnych metod.
Jak to działa
Sercem frameworka Thinkless są dwa kluczowe tokeny sterujące: <short> i <think>. Wyznaczają one złożoność odpowiedzi: pozwalają modelowi generować zwięzłe wyniki, gdy to wystarcza, albo prowadzić bardziej rozbudowane rozumowanie, gdy pojawiają się komplikacje. W trenowaniu Thinkless wykorzystuje zestawy danych z różnych benchmarków, m.in. Minerva Algebra, MATH-500 i GSM8K, co pokazuje jego świetną skuteczność w zadaniach rozumowania i skuteczne ograniczanie niepotrzebnego długiego łańcucha myślenia.
Najważniejsze funkcje
- Rozumowanie adaptacyjne: Thinkless dostosowuje generowanie odpowiedzi do złożoności zadania i możliwości modelu, dzięki czemu jest bardzo wszechstronny.
- Większa wydajność: Framework znacznie ogranicza potrzebę rozbudowanych ścieżek rozumowania, co przekłada się na poprawę wyników w różnych benchmarkach i zmniejsza zapotrzebowanie na długie łańcuchy myślenia o 50–90%.
- Uczenie ze wzmocnieniem: Thinkless wykorzystuje framework uczenia ze wzmocnieniem, który nie tylko lepiej uczy rozumieć złożoność zadań, ale też przewiduje, kiedy konieczne jest głębsze rozumowanie.
- Wyniki empiryczne: Najnowsze wersje frameworka osiągnęły bardzo dobre wyniki w testach empirycznych, co potwierdza innowacyjne podejście do trenowania i rozumowania LLM.
Instalacja i użycie
Konfiguracja Thinkless jest prosta i można ją wykonać bezpośrednio w środowisku conda. Instalacja obejmuje przygotowanie zależności Pythona, pobranie odpowiednich komponentów modelu z oficjalnego repozytorium i uruchomienie trenowania prostym poleceniem w wierszu poleceń. Szczegółowa dokumentacja w repozytorium przeprowadza przez konfigurację, ułatwia start i usuwa niejasności.
Podsumowanie
Thinkless to przyszłościowe narzędzie, które zmienia sposób, w jaki LLM radzą sobie ze złożonymi zadaniami rozumowania, znacząco poprawiając wydajność obliczeń i dokładność odpowiedzi. Dzięki innowacyjnej konstrukcji i praktycznym zastosowaniom Thinkless jest ważnym zasobem zarówno dla badaczy, jak i praktyków w szybko rozwijającej się dziedzinie sztucznej inteligencji. Dalszy rozwój zapewnia, że narzędzie odpowiada nie tylko na obecne potrzeby, ale też dostosowuje się do przyszłych wyzwań w świecie dużych modeli językowych i zaawansowanego rozumowania.
Zalety i wady
Zalety
- Rozumowanie adaptacyjne poprawia wydajność wykonywania zadań.
- Wykorzystuje unikalny model uczenia ze wzmocnieniem z dwoma tokenami sterującymi.
- Znacznie ogranicza użycie długich łańcuchów rozumowania i przyspiesza obliczenia.
Wady
Najczęściej zadawane pytania
Ile kosztuje Thinkless?
Thinkless jest open source i można z niego korzystać za darmo.
Czy Thinkless ma ofertę dożywotnią?
Według naszych najnowszych informacji to narzędzie niestety nie ma obecnie oferty dożywotniej.
Czym jest algorytm Decoupled Group Relative Policy Optimization (DeGRPO) w Thinkless?
Algorytm DeGRPO jest sercem frameworka Thinkless. Rozkłada cel uczenia rozumowania hybrydowego na dwa osobne składniki: stratę tokenu sterującego i stratę odpowiedzi. Dzięki temu można precyzyjnie kontrolować wkład każdego celu podczas trenowania. Strata tokenu sterującego określa, jak model wybiera między krótkim a długim rozumowaniem, a strata odpowiedzi zwiększa dokładność generowanych odpowiedzi. Stabilizując trenowanie i zapobiegając załamaniu, DeGRPO znacząco poprawia wyniki w różnych benchmarkach rozumowania.
Jak Thinkless poprawia wydajność obliczeniową rozumowania LLM?
Thinkless zwiększa wydajność obliczeniową, pozwalając modelom językowym adaptacyjnie wybierać między krótkim a długim rozumowaniem w zależności od złożoności zadania i możliwości modelu. Ograniczając potrzebę długiego łańcucha myślenia o 50–90%, Thinkless zmniejsza zużycie zasobów podczas wnioskowania, zachowując, a nawet poprawiając dokładność wyników. Czyni to go bardziej wydajnym niż tradycyjne podejścia do rozumowania w dużych modelach językowych.
Jakie są wymagania systemowe do instalacji Thinkless?
Aby zainstalować Thinkless, trzeba utworzyć środowisko z Pythonem 3.10 i niezbędnymi zależnościami. W szczególności należy użyć Condy do utworzenia nowego środowiska i zainstalować pakiety, takie jak PyTorch, LM_eval i Ray. Do obsługi CUDA zainstaluj odpowiednią wersję NVIDIA CUDA. Szczegółowe polecenia instalacji znajdziesz w pliku README projektu na GitHubie. Sprawdź dokumentację pod kątem dodatkowych wymagań zależnych od Twojej konfiguracji.
Czy Thinkless można zintegrować z innymi frameworkami uczenia maszynowego?
Tak, Thinkless został zaprojektowany z myślą o integracji z popularnymi frameworkami uczenia maszynowego, takimi jak PyTorch, na co wskazuje instalacja pakietu torch jako zależności. Ponieważ opiera się na standardowych narzędziach, można go łączyć z innymi bibliotekami i frameworkami do zadań takich jak przetwarzanie danych i dalsze trenowanie modeli. Aby lepiej zrozumieć integrację, zapoznaj się z instrukcją instalacji i użycia w repozytorium GitHub.
Jak szybko zacząć korzystać z Thinkless?
Aby szybko zacząć z Thinkless, najpierw przygotuj środowisko programistyczne z wymaganą wersją Pythona i bibliotekami. Po aktywacji środowiska Conda możesz zaimportować AutoModelForCausalLM i AutoTokenizer z biblioteki transformers. Następnie załaduj model Thinkless i przygotuj prompty do rozumowania. Dokumentacja projektu zawiera przykładowe fragmenty kodu, które pokazują, jak generować odpowiedzi i skutecznie oceniać wyniki modelu.
Jak ocenić wydajność modelu Thinkless?
Wydajność modelu Thinkless możesz ocenić za pomocą skryptów ewaluacyjnych z repozytorium, które pozwalają uruchomić wiele powtórzeń wnioskowania. Pomaga to zebrać wyniki dla różnych zadań i metryk. Narzędzie ewaluacyjne opiera się na promptach z OpenAI/simple-evals, a polecenia ewaluacji pozwalają wygenerować metryki z wyników zapisanych w calcs, takie jak dokładność i jakość odpowiedzi, które pomagają zrozumieć możliwości modelu.
Jakie są potencjalne ograniczenia Thinkless?
Choć Thinkless znacząco poprawia wydajność w zadaniach rozumowania, do potencjalnych ograniczeń należą zależność od jakości modelu początkowego i danych treningowych. Algorytm może też nie działać optymalnie w konkretnych, bardzo złożonych zadaniach wymagających głębokiego zrozumienia kontekstu. Dostrajanie hiperparametrów, takich jak thinkless_alpha i correct_think_reward, może też wymagać eksperymentów, by uzyskać najlepsze wyniki, co bywa czasochłonne.
Czy są zalecane strategie dostrajania modelu Thinkless?
Przy dostrajaniu Thinkless możesz zacząć od zmiany hiperparametrów, takich jak thinkless_alpha i correct_think_reward. Jeśli zbieżność jest wolna lub model faworyzuje jeden tryb rozumowania, rozważ stopniowe zwiększanie tych parametrów. Poprawić wyniki pomaga też eksperymentowanie z różnymi zestawami danych treningowych i technikami opisanymi w dokumentacji projektu, dopasowanymi do Twojego przypadku.
Porównania: Thinkless
Uwaga: ta strona używa linków afiliacyjnych, dzięki którym zarabia prowizję od sprzedaży. Przed rejestracją zapoznaj się z regulaminem danej usługi.