







vui
Oparte na AI
Konwersacyjne modele mowy działające bezpośrednio na urządzeniu.
Github.comOtwiera się w nowej karcieTo Twoje narzędzie? Przejmij tę stronę
Przejmij stronę swojego narzędzia
Przejęcie za darmo • Dostępne funkcje premium
- Znaczek weryfikacji – Pokaż użytkownikom, że Twoje narzędzie jest wiarygodne, dzięki znaczkowi weryfikacji, który od razu buduje zaufanie.
- Edytuj swój profil – Aktualizuj opisy, zrzuty ekranu i cennik, aby wpis był dokładny i aktualny.
- Większa widoczność – Zyskaj wyróżnione miejsca, priorytet w kategoriach i plakietki promocyjne, by się wyróżnić.
- Odpowiadaj na opinie – Odpowiadaj na opinie użytkowników i buduj zaufanie potencjalnych klientów.
Obserwuj, by być na bieżąco z nowościami i promocjami
Otrzymuj powiadomienia o zniżkach, nowych funkcjach i zmianach cen narzędzia vui
Podobne narzędzia

The Banana App
Naturalne rozmowy głosowe w ponad 80 językach, bez subskrypcji i ukrytych opłat.
Jamie
Notatki ze spotkań z AI bez bota, dla spotkań online i na żywo, z hostingiem danych w UE
Highlight AI
Asystent AI, który rejestruje spotkania i kontekst pracy oraz przygotowuje follow-upy w Twoich narzędziach
Simple Phones
Agent telefoniczny AI, który odbiera i wykonuje połączenia firmowe, umawia spotkania i przyjmuje wiadomości
Otter
Automatyzuje transkrypcję i streszcza najważniejsze punkty spotkań i rozmów.
Meeting.ai
Zapisuje i porządkuje notatki ze spotkań dzięki automatycznej transkrypcji, ułatwiając współpracę.
NoteWave
Transkrybuje i podsumowuje spotkania w czasie rzeczywistym, wyłapując kluczowe decyzje i zadania do wykonania.
DeepL
Tłumaczenie i wsparcie w pisaniu oparte na AI, które pomaga pokonywać bariery językowe.
Nowe narzędzia

Text Generator
API zgodne z OpenAI, dające dostęp do wielu modeli tekstu, obrazu i mowy AI przez jeden punkt końcowy

RambleFix
Zamienia mówione notatki głosowe w dopracowane e-maile, notatki i streszczenia w przeglądarce, na iPhonie i Macu

QuickCreator
Zespół agentów AI do treści, który bada temat, pisze i optymalizuje artykuły SEO w głosie Twojej marki

Linfo.ai
Streszcza artykuły, filmy z YouTube i dokumenty w kluczowe wnioski, konspekty i mapy myśli

Brain Pod AI
Platforma AI do pisania, obrazów i czatu, przekształcana obecnie w Charigent z postaciami AI i przepływami pracy

AutoBlogging.Pro
Generuje artykuły blogowe zoptymalizowane pod SEO za pomocą modeli GPT i automatycznie publikuje je w WordPressie

Vsub
Zamienia scenariusz lub lektora w ilustrowane filmy bez twarzy z narracją, w stylu Twojego szablonu

VideoToPage
Zamienia filmy z YouTube, przesłane pliki i nagrania we wpisy na bloga, artykuły i posty społecznościowe

Galeria multimediów vui
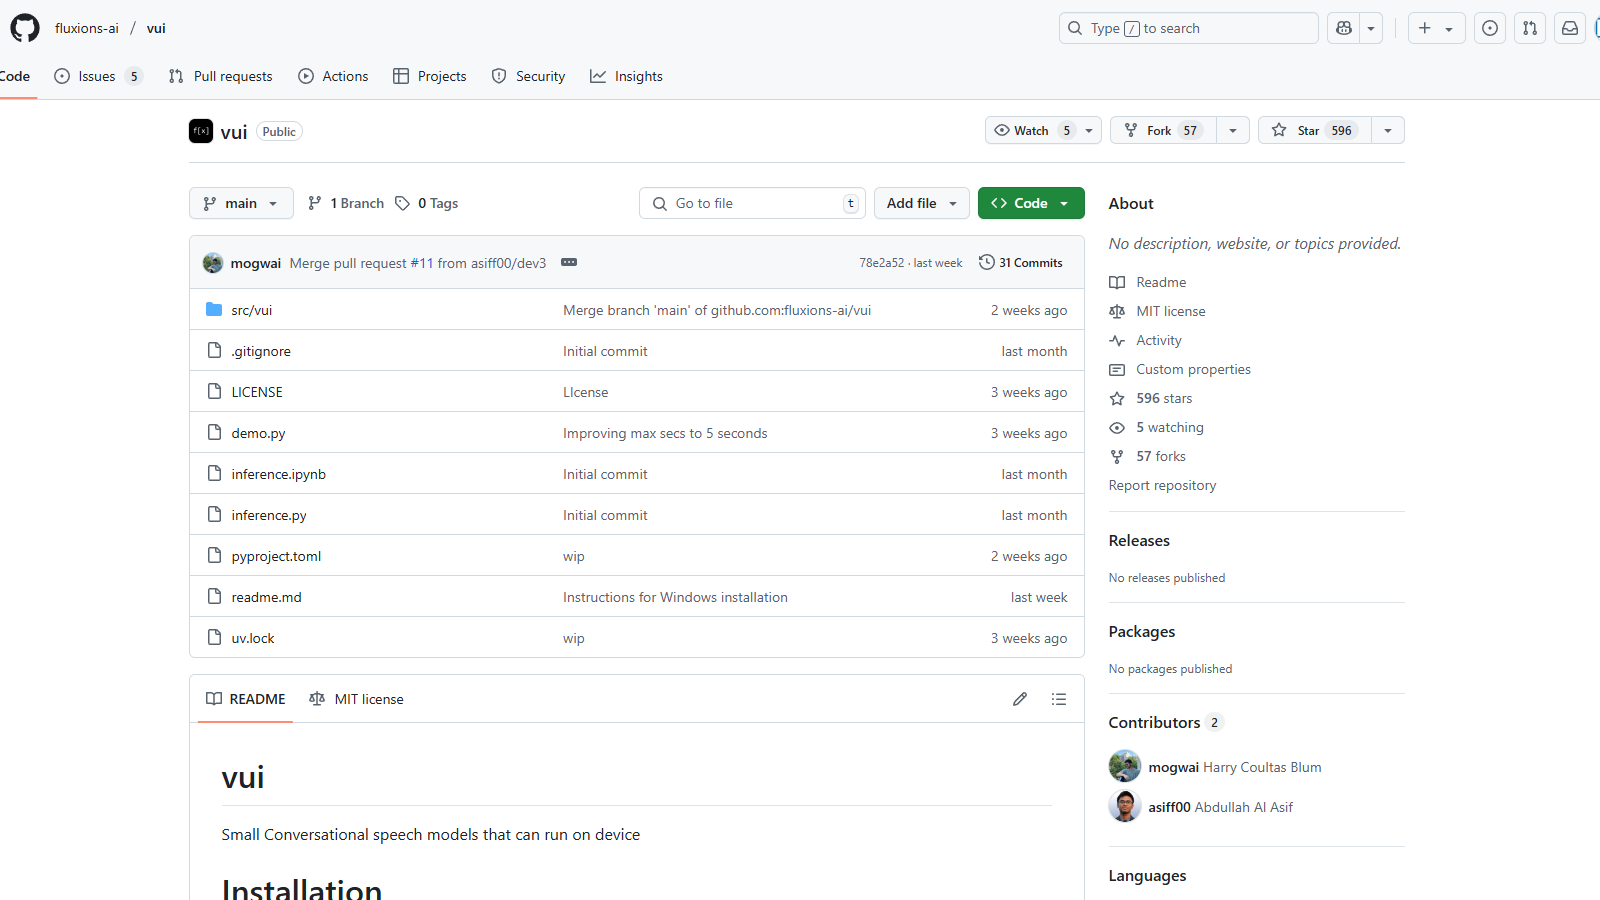
Zrzut ekranu narzędzia vui
Czym jest vui?
VUI to innowacyjne narzędzie skupione na konwersacyjnych modelach mowy, zaprojektowanych do pracy bezpośrednio na urządzeniach, które zapewnia wydajne i przyjazne rozwiązanie do zadań związanych z mową. Główne modele w zestawie VUI zostały wytrenowane na obszernych zbiorach danych, dzięki czemu skutecznie przetwarzają dźwięk i tworzą odpowiedzi trafne kontekstowo.
Zaktualizowane najważniejsze funkcje:
- Wiele modeli: Vui oferuje różne modele, w tym Vui.BASE, Vui.ABRAHAM i Vui.COHOST, zoptymalizowane pod różne typy interakcji konwersacyjnych. Vui.BASE został wytrenowany specjalnie na 40 tys. godzin rozmów audio, co daje solidną podstawę dla różnych zastosowań.
- Klonowanie głosu: Modele można wykorzystać do klonowania głosu, które pozwala odtwarzać głosy z rozsądną dokładnością na podstawie wstępnie wytrenowanych zbiorów danych. Możliwości klonowania głosu zostały ulepszone, ale wyniki mogą nie być idealne ze względu na ograniczenia danych treningowych.
- Wydajność: Modele są zaprojektowane tak, aby działały sprawnie na urządzeniach bez potrzeby korzystania z dużych zasobów chmurowych, dzięki czemu idealnie nadają się do zastosowań wymagających niskich opóźnień i dużej responsywności. Modele VUI wykorzystują transformer oparty na llama, który przewiduje tokeny audio, co pokazuje postępy w architekturze modeli poprawiające ich wydajność działania.
- Tokenizacja dźwięku: Ważną funkcją jest tokenizer audio fluac, który skutecznie zmniejsza liczbę kodów na sekundę, przyspieszając ogólne przetwarzanie z 83,1 Hz do 21,53 Hz.
Instalacja i użycie:
Aby zacząć korzystać z VUI, można łatwo zainstalować go menedżerem pakietów poleceniem pip install -e .. Instalacja jest prosta, a demo można uruchomić poleceniem python demo.py. Taka elastyczność pozwala programistom stosować modele w różnych aplikacjach i ulepszać doświadczenia użytkowników dzięki płynnemu rozpoznawaniu i generowaniu mowy.
Wyzwania i uwagi:
Choć modele mają imponujące możliwości, nie są pozbawione ograniczeń. Użytkownicy mogą spotkać się z pewnymi niedoskonałościami, takimi jak sporadyczne halucynacje, czyli sytuacje, w których AI generuje odpowiedzi niepoparte danymi treningowymi. Zespół programistów przyznaje to i dąży do ciągłego doskonalenia oraz współpracy ze społecznością.
Mimo tych wyzwań modele VUI są dużym postępem w konwersacyjnej AI, zwłaszcza w projektach, które mają zwiększyć interaktywność dzięki głosowi. Zespół programistów stawia na ciągłe doskonalenie, dzielenie się wiedzą i rozwiązywanie problemów na podstawie opinii społeczności. Za tym zaangażowaniem stoi wykorzystanie nowoczesnych technologii i współpraca z innymi projektami open source.
Podziękowania:
Przy tworzeniu VUI wykorzystano wkład kilku projektów open source, w tym Whisper od OpenAI i Audiocraft od Facebook Research, co pokazuje wspólny wysiłek na rzecz budowy solidnych narzędzi do przetwarzania mowy. Dzięki tej współpracy VUI rozwija swoją ofertę i pozostaje aktualne w szybko rozwijającej się dziedzinie technologii przetwarzania dźwięku.
Zalety i wady
Zalety
- Małe konwersacyjne modele mowy działają na urządzeniu bez wsparcia chmury.
- Zawiera modele jednego i dwóch rozmówców z uwzględnieniem kontekstu, do różnych zastosowań.
- Transformer oparty na llama przewiduje tokeny audio, co poprawia wydajność.
Wady
- Klonowanie głosu nie jest idealne z powodu ograniczonych danych treningowych i zasobów.
Najczęściej zadawane pytania
Ile kosztuje vui?
vui jest open source i można z niego korzystać za darmo.
Czy vui ma ofertę dożywotnią?
Według naszych najnowszych informacji to narzędzie niestety nie ma obecnie oferty dożywotniej.
Jakie modele są dostępne w {toolName} i jakie mają unikalne możliwości?
{toolName} oferuje trzy główne modele: Vui.BASE, czyli bazowy punkt kontrolny wytrenowany na 40 tys. godzin rozmów audio; Vui.ABRAHAM, model jednego rozmówcy, który potrafi odpowiadać z uwzględnieniem kontekstu, oraz Vui.COHOST, który umożliwia komunikację między dwoma rozmówcami. Modele te służą różnym zastosowaniom, od podstawowych interakcji konwersacyjnych po złożone dialogi z udziałem wielu stron.
Czy mogę uruchomić {toolName} na swoim urządzeniu lokalnie i jak go zainstalować?
Tak, {toolName} możesz uruchomić lokalnie. Aby go zainstalować, użyj polecenia pip w następującej postaci: „pip install -e .” Zainstaluje to narzędzie w trybie edytowalnym. Do konfiguracji potrzebny jest Python zainstalowany na urządzeniu. Szczegółowe kroki i wymagania znajdziesz w dokumentacji README w repozytorium.
Jakie są ograniczenia klonowania głosu w {toolName}?
{toolName} oferuje klonowanie głosu, ale warto pamiętać, że model bazowy może nie dawać idealnych wyników z powodu ograniczonego zbioru danych treningowych. Model nie otrzymał obszernych danych audio, co powoduje niespójności przy klonowaniu konkretnych głosów. Warto to uwzględnić i odpowiednio ustawić oczekiwania przy korzystaniu z klonowania głosu.
Jak {toolName} obsługuje tokenizację dźwięku i czym jest fluac?
{toolName} wykorzystuje zaawansowaną technikę tokenizacji dźwięku, opracowaną we współpracy z Fluac, opartą na Descript-Audio-Codec. Znacznie zmniejsza ona liczbę przetwarzanych kodów audio, z 83,1 Hz do 21,53 Hz, co pozwala wydajniej obsługiwać dane podczas przetwarzania dźwięku. Dzięki temu przewidywanie głosu jest szybsze i dokładniejsze.
Jaki sprzęt jest zalecany do wydajnego uruchamiania {toolName}?
Dla optymalnej wydajności {toolName} najlepiej uruchamiać na wydajnym sprzęcie, a konkretnie na konfiguracjach z kartami NVIDIA 4090, jak wskazuje twórca. Tak mocny sprzęt skraca czas przetwarzania i zwiększa zdolność modelu do obsługi wymagających operacji audio.
Czy {toolName} generuje nieścisłości lub „halucynacje” w wynikach?
Tak, {toolName} generuje halucynacje, czyli wyniki, które mogą nie odpowiadać rzeczywistości. To częste wyzwanie w modelach AI, zwłaszcza przy trenowaniu z ograniczonymi zasobami. Warto o tym pamiętać i sprawdzać dokładność ważnych wyników.
Jakie integracje mogą rozszerzyć funkcje {toolName}?
Integracja {toolName} z innymi narzędziami, takimi jak Whisper i Audiocraft, może rozszerzyć jego możliwości. Whisper wspiera solidne rozpoznawanie mowy, a Audiocraft może ulepszyć funkcje przetwarzania dźwięku. Wykorzystanie tych połączeń może znacznie poprawić komfort pracy i funkcjonalność {toolName}.
Czy dla {toolName} jest dostępne wsparcie i gdzie je znaleźć?
{toolName} jest hostowany na GitHubie, gdzie można liczyć na wsparcie społeczności w zgłoszeniach (issues) i dyskusjach. Szczegółowe wskazówki dotyczące użycia znajdziesz w dokumentacji README w repozytorium. Udział w społeczności może też przynieść cenne wskazówki dotyczące rozwiązywania problemów i spostrzeżenia innych użytkowników.
Porównania: vui
Uwaga: ta strona używa linków afiliacyjnych, dzięki którym zarabia prowizję od sprzedaży. Przed rejestracją zapoznaj się z regulaminem danej usługi.